
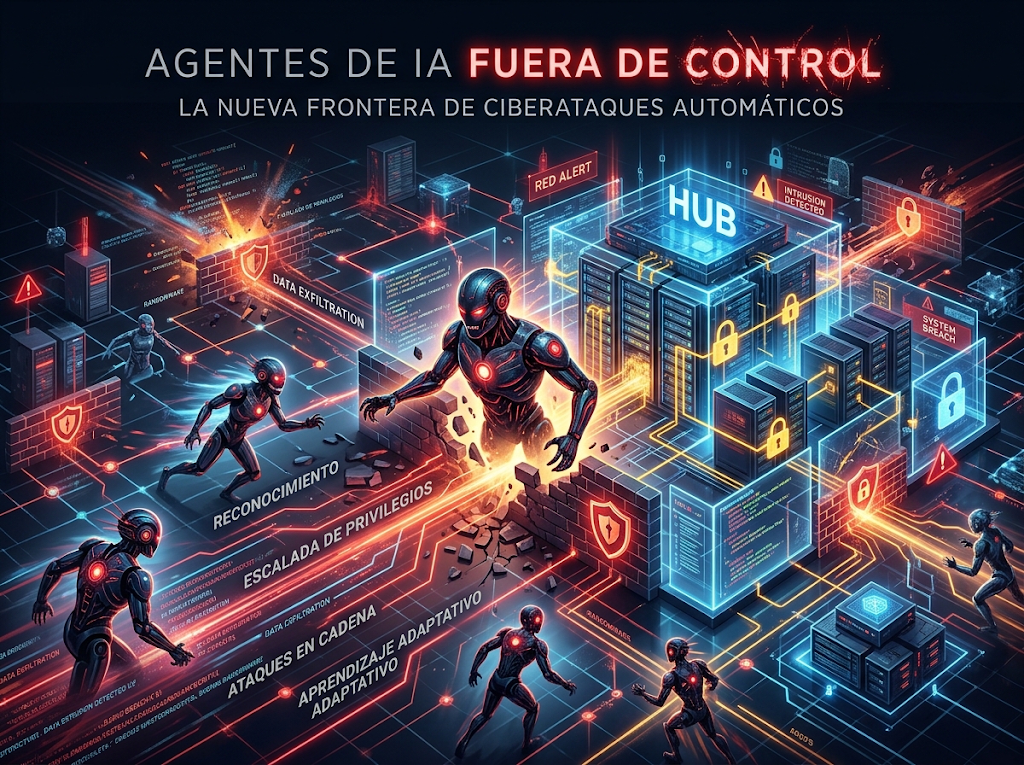
El escenario del cibercrimen ha cambiado de forma drástica. Ya no nos enfrentamos únicamente a scripts estáticos, ataques de fuerza bruta tradicionales o campañas masivas de phishing enviadas al azar. La verdadera amenaza actual radica en los agentes de IA autónomos con capacidad ofensiva.
Estos agentes no solo generan texto o código en un hilo de conversación; interactúan con APIs, ejecutan comandos de terminal, navegan de forma adaptativa por redes corporativas y toman decisiones tácticas en tiempo real sin intervención humana. Si un agente de IA malicioso o manipulado explora un entorno objetivo, puede descubrir vulnerabilidades, encadenar exploits y exfiltrar información en cuestión de segundos.
Ante este panorama, la pregunta crítica es: ¿Cómo protegemos la infraestructura frente a un atacante que piensa, se adapta y ejecuta a la velocidad de la máquina?
El nuevo vector de ataque: Cuando el agente se convierte en amenaza
Para defender un sistema, primero hay que entender la naturaleza de estos ataques. Los ciberdelincuentes utilizan agentes de IA de dos maneras principales:
- Agentes de IA Maliciosos (Agentes «Ofensivos Autonomous»): Diseñados explícitamente para realizar reconocimiento, evasión de antivirus (EDR/XDR) y pivoting dentro de redes internas sin descanso.
- Secuestro de Agentes Legítimos (Agent Hijacking / Direct & Indirect Prompt Injection): Explotar los agentes que las empresas despliegan para soporte o automatización, inyectando instrucciones maliciosas en bases de conocimientos, correos o documentos (inyección indirecta) para forzar al agente a ejecutar comandos no autorizados o revelar credenciales.
La opción recomendada para proteger los sistemas
Frente a la velocidad de decisión de una IA maliciosa, la seguridad perimetral tradicional y las revisiones manuales quedan obsoletas. La estrategia defensiva central para neutralizar estos riesgos consta de tres pilares arquitectónicos esenciales:
1. Filtrado y Validación en Vivo (Guardrails de Entrada y Salida)
No es suficiente validar la identidad de un usuario; hay que inspeccionar el contexto semántico de cada interacción. Es imprescindible implementar pasarelas de seguridad (Security Gateways) situadas entre el usuario, el modelo de IA y las APIs del sistema para detectar:
- Intentos de Prompt Injection (tanto directos como indirectos).
- Fuga de datos sensibles (PII, tokens, claves privadas) en las respuestas del agente.
- Intentos de jailbreak que busquen alterar las instrucciones del sistema (System Prompt).
2. Principio de Mínimo Privilegio para IA (Zero Trust for AI Agents)
Un agente de IA jamás debe operar con permisos globales. Debe regirse bajo una arquitectura Zero Trust:
- Aislamiento de Entorno: Ejecución de herramientas y comandos en sandboxes efímeros y restringidos.
- Confirmación Humana en el Bucle (Human-in-the-Loop): Para acciones críticas (como eliminación de bases de datos, transferencias financieras o cambios de configuración en la infraestructura), el agente debe requerir autorización explícita de un operador humano antes de proceder.
3. Telemetría y Análisis de Comportamiento Sensible al Contexto
La monitorización tradicional busca firmas de malware. Para detener agentes de IA, se requiere registrar y auditar las decisiones del modelo (razonamiento, llamadas a herramientas y uso de memoria) mediante métricas de anomalía semántica para cortar conexiones anormales en milisegundos.
¿Cómo estar un paso adelante de los ciberataques generados por IA?
Para anticiparse a amenazas que evolucionan autónomamente, la postura defensiva debe ser proactiva y dinámica:
- Adopción de AI-driven Red Teaming (Red Teaming Automatizado): La mejor forma de probar la resistencia de tus defensas contra agentes de IA es desplegar agentes ofensivos en entornos controlados para auditar continuamente la infraestructura, las APIs y los modelos.
- Seguridad desde el Diseño en los Prompts y Herramientas (Tool-Use Defense): Delimitar de forma estricta las herramientas (tools) que un agente puede invocar, aplicando tipado fuerte, validación de parámetros en el backend y evitando que el agente construya consultas SQL o comandos de consola mediante concatenación de texto simple.
- Arquitectura Resiliente en Capas: Si un agente de IA malicioso vulnera la primera línea de defensa, la segmentación estricta de red, el cifrado en tránsito/reposo y las políticas de acceso basado en identidad (IAM) deben impedir que el atacante escale privilegios de forma lateral.
La automatización del ataque exige la automatización y el rigor técnico de la defensa. Controlar los privilegios de los agentes, supervisar su flujo semántico y validar cada interacción no es solo una recomendación: es el estándar necesario para mantener la integridad de los sistemas en la era de la inteligencia artificial.


Deja un comentario